
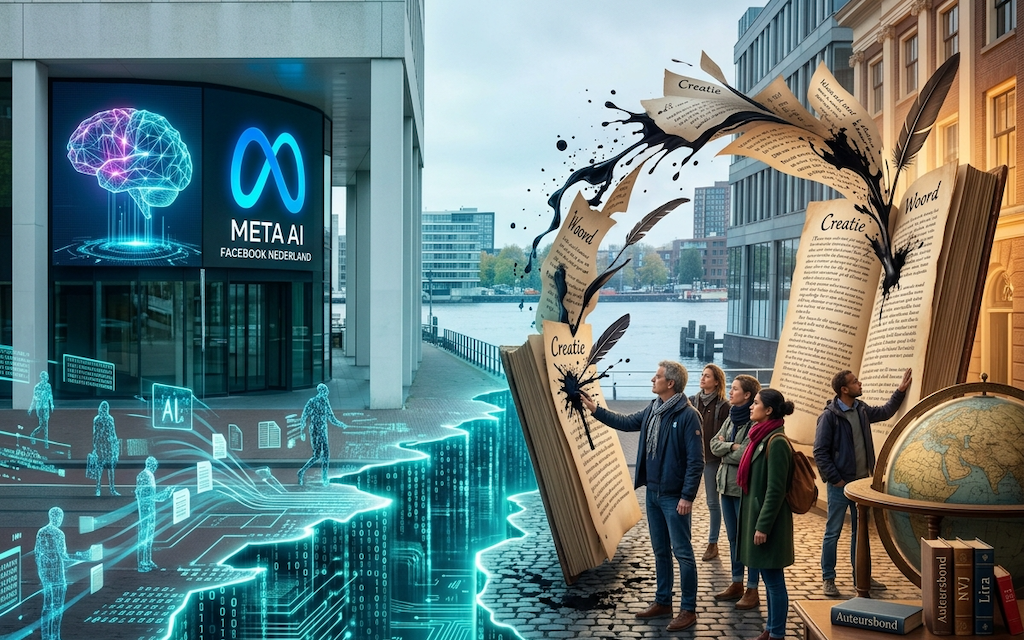
Op 29 september komen schrijvers, journalisten en vertalers in Amsterdam in actie tegen Meta. Maar de echte vraag is groter: wat gebeurt er met menselijke creativiteit wanneer technologie haar eerst nodig heeft en haar daarna probeert te vervangen?
Op dinsdag 29 september verzamelen schrijvers, journalisten en vertalers zich om 10.00 uur bij het hoofdkantoor van Facebook Nederland aan de Jollemanhof 15 in Amsterdam. De actie is georganiseerd door Stichting Lira, de Auteursbond en de Nederlandse Vereniging van Journalisten (NVJ). Hun boodschap is eenvoudig: ons werk is geen gratis grondstof voor Big Tech.
De organisaties hebben Meta eerder dit jaar gesommeerd te stoppen met het gebruik van auteursrechtelijk beschermd werk van Nederlandse schrijvers, vertalers en journalisten voor het trainen van AI-modellen. Zij eisen transparantie, zeggenschap en een eerlijke vergoeding. Volgens de organisaties wordt bij de ontwikkeling van AI-modellen bovendien gebruikgemaakt van zogenoemde shadow libraries: illegale verzamelingen van boeken en andere auteursrechtelijk beschermde werken.
Meta heeft volgens Lira, de Auteursbond en de NVJ onvoldoende ruimte geboden voor een gesprek. Daarom werken de organisaties toe naar een collectieve procedure en een collectieve regeling.
Dat klinkt als een Nederlandse auteursrechtenkwestie. Maar wie de ontwikkelingen van de afgelopen maanden volgt, ziet dat hier een veel groter gevecht achter zit.
De machine schrijft niet uit het niets
Er is een ongemakkelijke waarheid die we soms liever vergeten: kunstmatige intelligentie ontstaat niet uit het niets.
Een taalmodel leert patronen uit enorme hoeveelheden menselijke taal. Artikelen, boeken, recensies, interviews, vertalingen, scenario’s, essays en andere teksten vormen onderdeel van de culturele en intellectuele omgeving waaruit deze systemen worden ontwikkeld.
De vraag is dus niet alleen wat AI kan produceren.
De vraag is ook: van wie is het materiaal waarop die productie mogelijk is geworden?
In Nederland hebben inmiddels meer dan zeshonderd schrijvers, vertalers en journalisten gereageerd op een oproep om te controleren of hun werk voorkomt in bekende AI-datasets. Dat aantal laat zien dat het probleem niet beperkt is tot een paar bekende auteurs.
En precies daar ligt de kern van het conflict. Een individuele schrijver kan onmogelijk achterhalen waar al zijn of haar teksten terechtkomen, welke datasets zijn gebruikt en welke commerciële waarde daar uiteindelijk uit voortkomt. Voor een technologiebedrijf dat miljarden investeert in AI is individuele toestemming van iedere auteur evenmin praktisch.
Daarom vragen Lira, de Auteursbond en de NVJ om een collectieve regeling.
Dat is geen strijd tegen technologie. Het is een strijd om de voorwaarden waaronder technologie gebruikmaakt van menselijke arbeid.
De Nederlandse actie staat niet op zichzelf
Wie denkt dat dit alleen een conflict tussen Nederlandse auteurs en Meta is, hoeft maar naar de Verenigde Staten te kijken.
Daar woedt inmiddels een juridisch gevecht tussen auteurs, uitgevers en AI-bedrijven als OpenAI, Microsoft, Google en Anthropic. In de zaak rond OpenAI en Microsoft stellen auteurs dat hun boeken zonder toestemming zijn gekopieerd en gebruikt voor het trainen van AI-modellen. OpenAI en Microsoft verdedigen zich onder meer met het argument dat het trainen van modellen een transformatief gebruik van materiaal is en niet simpelweg hetzelfde als het aanbieden van de oorspronkelijke werken. De juridische discussie is dus nog volop gaande.
Maar de afgelopen weken is de discussie opnieuw geëscaleerd.
Nieuwe, openbaar geworden juridische documenten in de Amerikaanse zaak rond OpenAI en Microsoft bevatten interne communicatie over het gebruik van auteursrechtelijk beschermd materiaal. De documenten worden door de Authors Guild en andere betrokken partijen aangehaald als aanwijzing dat binnen de bedrijven al vroeg werd nagedacht over de juridische en economische risico’s van het gebruik van boeken en journalistieke content. Dat zijn standpunten van procespartijen in een lopende rechtszaak; de rechter moet de juridische vragen uiteindelijk beoordelen.
Ook de zaak rond Anthropic laat zien hoe groot de financiële belangen zijn. In juli werd een schikking van ongeveer 1,5 miljard dollar definitief goedgekeurd in een auteursrechtzaak over het gebruik van boeken. Volgens de schikkingsvoorwaarden kan voor elk betrokken illegaal gekopieerd boek een bedrag van 3.000 dollar worden uitgekeerd.
En in juli dienden uitgevers en auteurs in de Verenigde Staten een nieuwe collectieve zaak tegen Google in rond het gebruik van auteursrechtelijk beschermde werken voor Gemini.
Het patroon wordt daardoor steeds duidelijker: de discussie verschuift van “wat kan AI?” naar “onder welke voorwaarden mag AI zich onze culturele productie toe-eigenen?”
Maar laten we ook naar onszelf kijken
Toch zou het te gemakkelijk zijn om alleen naar Meta, Google, Microsoft, OpenAI of andere technologiebedrijven te wijzen.
Want ook wij, de makers, doen mee.
Ik schrijf. Ik vertaal. Ik maak journalistieke en audiovisuele content. En ik gebruik zelf AI-tools.
Daarmee zit ik midden in de paradox.
Ik kan AI gebruiken om een tekst sneller te structureren, een vertaling te controleren, ideeën te ordenen of een eerste versie van iets te analyseren. Het is verleidelijk. Soms is het ook gewoon handig.
Maar iedere keer dat een schrijver zijn volledige manuscript in een AI-systeem stopt, iedere keer dat een vertaler honderden pagina’s invoert om ze sneller te laten verwerken, iedere keer dat een journalist zijn eigen onderzoek, interviews of ongepubliceerde teksten uploadt, gebeurt er nog iets anders.
We geven een deel van onze intellectuele arbeid uit handen.
En soms weten we onvoldoende wat er vervolgens met die informatie gebeurt.
Dat betekent niet dat iedere AI-dienst automatisch onze teksten “steelt” of dat iedere ingevoerde tekst automatisch voor training wordt gebruikt. De voorwaarden, instellingen en technische systemen verschillen per dienst. Maar het betekent wél dat wij als makers veel kritischer moeten worden over wat we uploaden, waar we het uploaden en onder welke voorwaarden.
We kunnen niet tegelijkertijd eisen dat technologiebedrijven respect hebben voor onze intellectuele eigendom en zelf zonder nadenken al ons werk in commerciële AI-systemen stoppen.
Dat is mijn eigen ongemakkelijke conclusie.
AI kan onze creativiteit versterken — maar ook verzwakken
Er is nog een ander gevaar dat moeilijker juridisch te meten is.
Wat gebeurt er met onze eigen creativiteit als we steeds vaker aan een machine vragen wat we moeten schrijven?
Een schrijver die AI laat brainstormen, een journalist die AI een eerste analyse laat maken, een vertaler die iedere moeilijke zin door een taalmodel laat herschrijven: het kan tijd besparen.
Maar creativiteit bestaat niet alleen uit efficiëntie.
Een onverwachte formulering. Een vreemde associatie. Een persoonlijke herinnering. Een fout die ineens interessant blijkt. Een zin die je drie keer herschrijft voordat hij eindelijk klopt.
Juist daar zit vaak het menselijke.
Als we die stappen voortdurend uitbesteden, bestaat het risico dat we niet alleen arbeid besparen, maar ook een stukje van onze eigen creatieve spierkracht minder gebruiken.
En misschien is dat uiteindelijk een groter gevaar dan AI die simpelweg een schrijver vervangt.
Een schrijver die wordt vervangen, kan protesteren.
Een schrijver die langzaam verleert om zelf te schrijven, merkt het misschien veel later.
Het gaat uiteindelijk niet alleen om geld
Daarom vind ik de discussie over een “eerlijke vergoeding” belangrijk, maar niet voldoende.
Natuurlijk moeten makers betaald kunnen worden wanneer hun werk commercieel wordt gebruikt.
Maar er gaat nog iets anders verloren wanneer teksten zonder duidelijke toestemming en transparantie in enorme datasets verdwijnen: zeggenschap.
Een schrijver moet kunnen weten dat zijn werk is gebruikt.
Een vertaler moet kunnen weten dat haar vertaling onderdeel is geworden van een commercieel systeem.
Een journalist moet kunnen weten dat jarenlang journalistiek werk niet alleen wordt gelezen, maar mogelijk ook wordt ingezet om een systeem te bouwen dat vervolgens antwoorden produceert waarvoor de oorspronkelijke bron nauwelijks nog wordt geraadpleegd.
En uiteindelijk moet ook de samenleving zich afvragen wat zij wil.
Willen we een internet waarop steeds meer content door machines wordt gegenereerd, terwijl de mensen die de oorspronkelijke kennis, verhalen en cultuur produceren steeds minder kunnen leven van hun werk?
Of willen we technologie die menselijke creativiteit ondersteunt en daar eerlijk mee omgaat?
Dat is geen keuze tussen “voor” of “tegen” AI.
Het is een keuze over welke economie en welke cultuur we rond AI willen bouwen.
29 september is daarom meer dan een protest tegen Meta
De actie van Lira, de Auteursbond en de NVJ op 29 september is symbolisch.
Een groep schrijvers, journalisten en vertalers staat voor een gebouw van een van de grootste technologiebedrijven ter wereld en zegt: afblijven van ons werk, tenzij daar toestemming, transparantie en een eerlijke regeling tegenover staat.
Maar misschien moeten wij als makers tegelijkertijd naar ons eigen toetsenbord kijken.
Welke teksten voeren wij in?
Welke ideeën delen wij?
Welke vertalingen laten we door een machine maken?
Welke foto’s, scripts, interviews en manuscripten uploaden we?
En hoeveel van onze eigen creatieve beslissingen laten we inmiddels door een algoritme nemen?
Mijn positie is daarom niet: stop AI.
Mijn positie is ook niet: laat AI alles overnemen.
Mijn positie is veel eenvoudiger: laten we technologie gebruiken zonder te vergeten wie het materiaal, de kennis, de verhalen en de verbeelding heeft gemaakt waarop die technologie drijft.
AI heeft geen behoefte aan erkenning.
De mens die de tekst schreef wel.
De vertaler die uren aan een zin werkte wel.
De journalist die een bron vond en het risico nam om een verhaal te publiceren wel.
De kunstenaar die jarenlang zijn vak ontwikkelde wel.
En misschien moeten wij, juist nu AI steeds beter wordt, opnieuw leren om die menselijke arbeid zichtbaar te maken.
Want zonder makers is er uiteindelijk niets om door een machine te laten leren.


